Словарь ИИ-терминов простыми словами: промпт, сид, диффузия, LoRA и не только

Автор и практик в сфере генеративных технологий, специализирующийся на создании визуального контента с помощью нейросетей. В своих материалах она простым языком объясняет, как работает генерация изображений и как применять её для задач маркетинга, дизайна и digital-проектов. Ключевое направление — генерация изображений по фото (image-to-image), разработка точных промптов и управление визуальным стилем. Мари показывает, как получать предсказуемый результат: настраивать композицию, освещение, детализацию и адаптировать изображения под разные форматы — от соцсетей до рекламных баннеров. Контент автора помогает не просто разобраться в технологии, а встроить генерацию изображений в рабочие процессы: ускорить создание креативов, снизить затраты и повысить эффективность визуального контента.
Представьте, вы открываете нейросеть — и сразу видите незнакомые слова: промт, сид, денойзинг, LoRA, CFG scale.
Обилие терминов может фрустрировать, особенно в самом начале работе с ИИ. Хорошая новость: знать всё не обязательно. Но несколько ключевых понятий кардинально меняют результат. Давайте разложим их «по полочкам», чтобы они больше никогда не вызывали путаницы.
Зачем вообще знать эти термины
Нейросеть — не волшебная кнопка «сделать красиво». Это инструмент с параметрами, и каждый параметр что-то контролирует. Когда вы понимаете, что делает промт, а что — сид, вы перестаёте гадать и начинаете управлять результатом осознанно.
Не переживайте, для комфортной работы не придется читать научные статьи. Достаточно бытового понимания: что за что отвечает, что можно крутить, а что лучше не трогать без опыта.
Промпт (prompt)

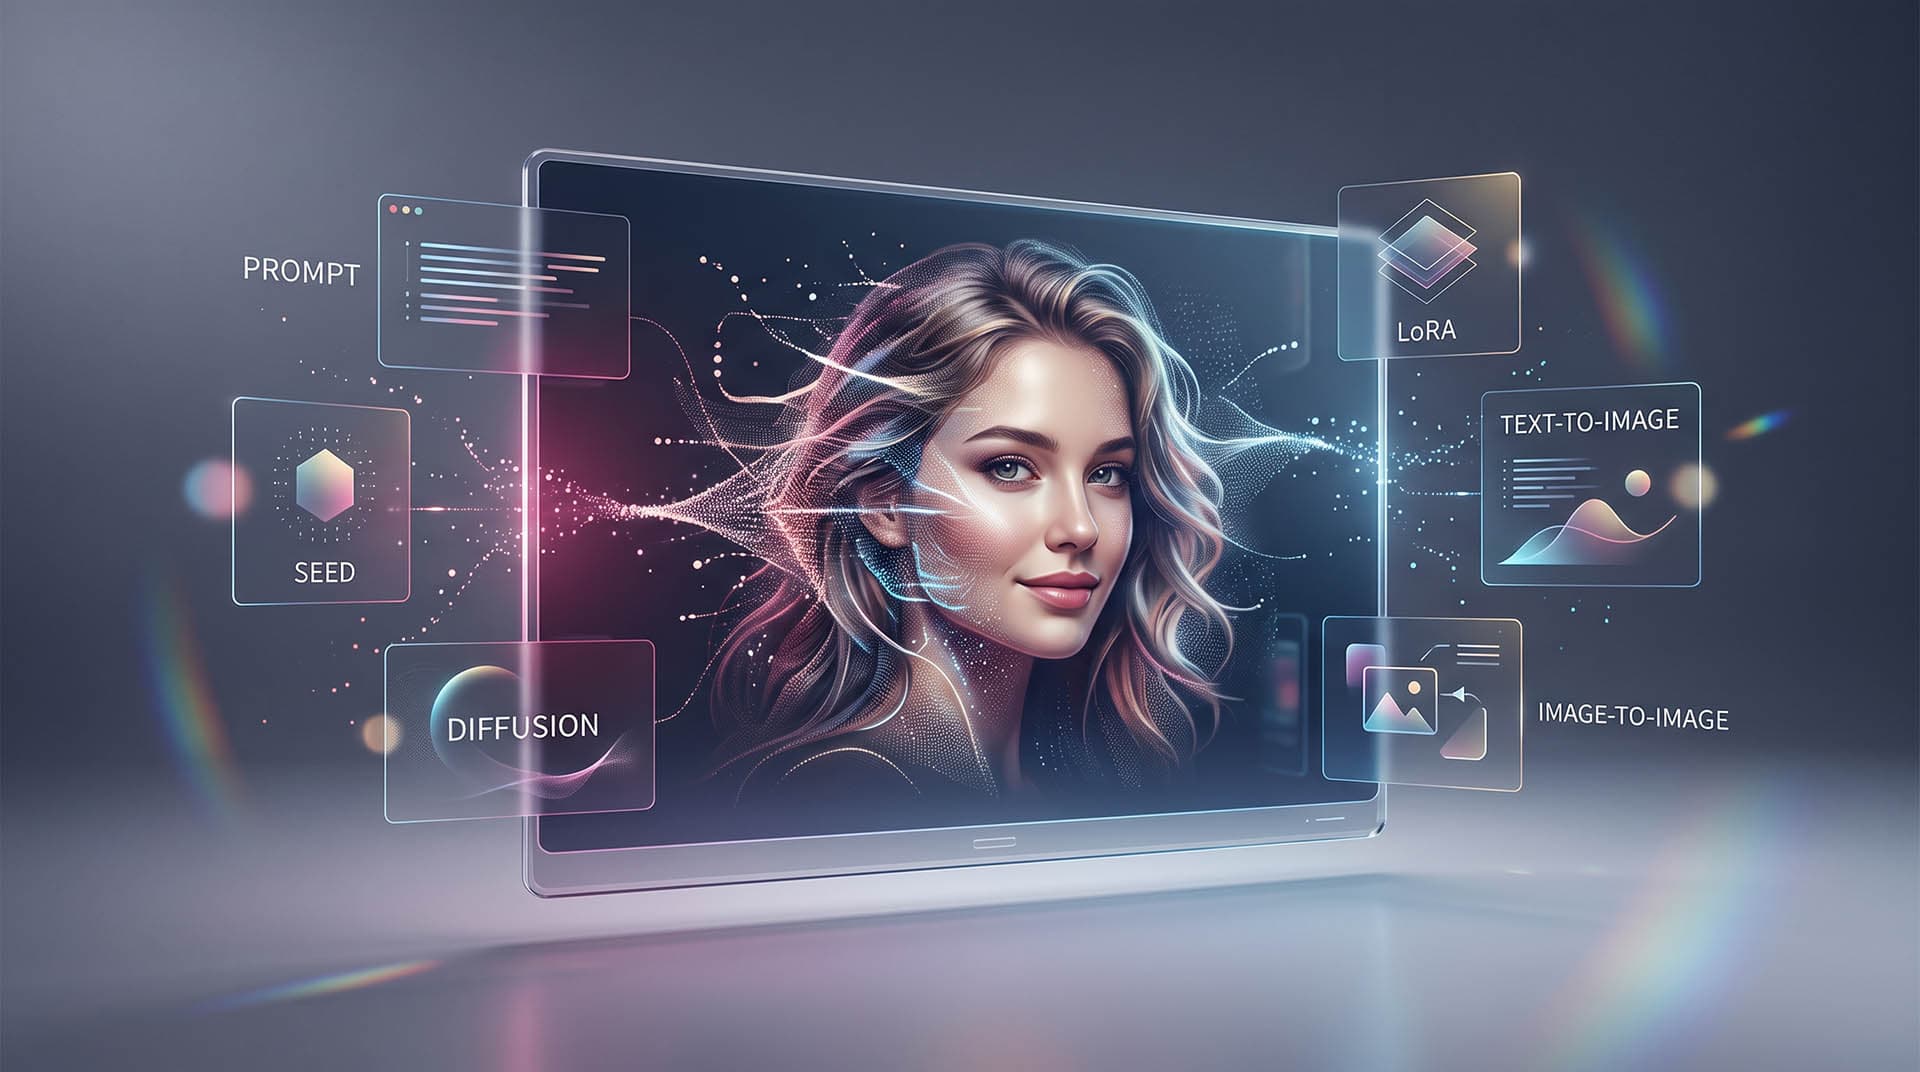
Промпт (промт, prompt) — это текстовое описание-инструкция, которую вы даёте нейросети: именно на его основе она генерирует изображение. Это самый важный параметр — от промпта зависит буквально всё.
Аналогия: промпт — это техническое задание для художника. Чем точнее вы описываете, что хотите, тем ближе результат к вашей идее. «Нарисуй что-нибудь красивое» и «портрет молодой женщины с рыжими волосами, мягкий вечерний свет, стиль масляной живописи» — принципиально разные задания.
Как влияет на картинку: промт определяет содержание, стиль, настроение, детали, освещение — всё. Если результат не тот, в 9 случаях из 10 дело в промте.
Что делает промпт сильным:
- Конкретность: «большой рыжий кот на красной диване» лучше, чем «кот»
- Уточнение стиля: «акварель», «фотореализм», «мультяшный стиль»
- Описание освещения: «мягкий утренний свет», «студийное освещение», «золотой час»
- Указание настроения: «уютно», «эпично», «минималистично»
«Промт — это единственный способ разговаривать с нейросетью. Чем точнее вы формулируете задачу, тем предсказуемее результат — модель буквально делает то, о чём её просят, а не то, что вы имели в виду».
Что такое негативный промт
Негативный промт (negative prompt) — это список того, что вы просите нейросеть не рисовать. Иногда это отдельное поле, где вы перечисляете нежелательные элементы. Но чаще он пишется как часть обычного промпта в самом конце.
Аналогия: вы говорите художнику «и пожалуйста, без синего фона, без размытия и без лишних людей в кадре».
Диффузия и диффузионная модель

Диффузионная модель (diffusion model) — это тип нейросети, которая генерирует изображения, постепенно «очищая» случайный шум и превращая его в картинку. Большинство современных генераторов изображений — например, Nano Banana — работают именно с помощью диффузии.
Аналогия: представьте проявку старой фотографии в тёмной комнате. Сначала — белый лист, потом постепенно проступают контуры, детали, цвета. Диффузионная модель делает примерно то же самое, только в цифровом виде и в обратную сторону: она обучена убирать «шум» шаг за шагом, пока из хаоса не появится изображение.
Или другая аналогия: скульптор, который лепит из бесформенного куска глины — каждый шаг убирает лишнее, и постепенно появляется фигура.
Как это работает на практике:
- Нейросеть начинает с чистого случайного шума — набора случайных пикселей
- Шаг за шагом (их может быть 20, 30, 50) она «убирает шум», ориентируясь на ваш промт
- После каждого шага изображение становится чуть более похожим на то, что описано в промте
- К последнему шагу шум превращается в картинку
«Диффузионные модели научились синтезировать реалистичные изображения, шаг за шагом убирая случайные искажения из шума — в точности как обращение времени в хаотичном физическом процессе. Каждый шаг добавляет структуру и смысл».
Сид (seed)
Сид (seed, «семя») — это число, которое задаёт начальную точку генерации: какой именно случайный шум станет отправной точкой для картинки. Одинаковый сид + одинаковый промт = похожий результат.
Аналогия: сид — это как конкретная горсть глины. Из разной глины один и тот же скульптор вылепит похожие, но чуть разные фигуры. Из одной и той же горсти — почти одинаковые.
Зачем фиксировать сид:
- Если вам понравился результат — запишите сид, чтобы воспроизвести его позже
- Если хотите поменять только один элемент (например, цвет одежды) — оставьте сид и измените только промт
- Если нужна серия похожих изображений — используйте один сид с небольшими вариациями промта
Как влияет на картинку: определяет «версию» генерации. Без фиксированного сида каждый раз получается разный результат из одного промта — это и хорошо (разнообразие), и плохо (непредсказуемость). С фиксированным сидом результат воспроизводим.
Практически: в большинстве сервисов сид показывается под готовой картинкой или в её параметрах. Просто скопируйте его — и сможете вернуться к этому «варианту» в любой момент.
LoRA простыми словами

LoRA (Low-Rank Adaptation, адаптация низкого ранга) — это небольшой дополнительный «модуль», который дообучают поверх основной модели на наборе конкретных фотографий, чтобы научить её воспроизводить определённое лицо, стиль или объект.
Аналогия: представьте, что основная модель — это опытный художник. LoRA — это папка с референсами, которую вы даёте ему перед работой: «вот как выглядит этот человек, вот этот стиль». Художник не переучивается заново — он просто использует референсы.
С помощью LoRA можно генерировать вашу внешность в любой сцене или воспроизводить конкретные объекты (например, товары брендов для рекламы)
Low-Rank Adaptation
«Low-Rank Adaptation» буквально означает «адаптация с использованием матриц низкого ранга» — это математический способ добавить в большую модель небольшой набор дополнительных весов, не трогая основные. В результате файл LoRA весит несколько мегабайт (против гигабайт у полной модели), обучается быстро и точечно меняет только то, чему его учили.
Именно на принципе LoRA работает персонализация в AVALAVA: вы загружаете свои фото, сервис обучает мини-модель на вашем лице — и дальше генерирует вас в любых образах.
Text-to-image и image-to-image
Это два основных режима работы с генераторами изображений
Text-to-image (текст → изображение) — вы даёте только текстовый промпт, модель создаёт картинку с нуля. Это исходный режим большинства генераторов, где изображение создается с чистового листа, только по вашему запросу.
Используйте, когда нужна полностью новая картинка без привязки к существующему изображению.
Image-to-image (изображение → изображение) — вы загружаете исходное фото или картинку и описываете, как хотите её изменить. Модель берёт ваш исходник как основу и трансформирует его согласно промпту.
Используйте, чтобыизменить стиль фотографии, добавить элементы, поменять фон, перекрасить объект, сделать из фото иллюстрацию.
Режим | Исходник | Результат |
Text-to-image | Только текст | Генерация с нуля |
Image-to-image | Фото + текст | Трансформация исходника |
В image-to-image ключевую роль играет параметр denoising strength (сила денойзинга) — о нём в следующем разделе.
CFG scale и denoising

CGG scale и denosing - два параметра, которые чаще всего вызывают вопросы. Главное правило: думайте о них как об опциональных ползунках.
CFG scale (guidance scale) — «ползунок послушности»
CFG scale (Classifier-Free Guidance scale, масштаб направляющего сигнала) — это параметр, который определяет, насколько строго модель следует вашему промту.
- Низкое значение (1–4): модель творчески интерпретирует промт, может отклоняться, добавлять своё
- Среднее значение (5–9): баланс между следованием промту и творческой свободой — обычно оптимально
- Высокое значение (10–20): модель очень строго придерживается промта, но изображение может стать «перенасыщенным» и потерять естественность
Аналогия: CFG scale — это степень буквальности. При высоком значении художник рисует именно то, что написано в ТЗ, слово в слово. При низком — вдохновляется вашим описанием и добавляет от себя.
Если картинка не соответствует описанию — попробуйте поднять CFG. Если выглядит «пережаренной» — снизить.
Denoising strength — «ползунок силы изменений»
Denoising strength (сила денойзинга / сила шумоподавления) работает только в режиме image-to-image и определяет, насколько сильно модель меняет исходное изображение.
- Низкое значение (0.1–0.4): лёгкие изменения, исходник почти не меняется — уточнение деталей, мягкая стилизация
- Среднее значение (0.5–0.7): заметные изменения при сохранении общей структуры — смена стиля, изменение элементов
- Высокое значение (0.8–1.0): радикальные изменения, исходник используется лишь как слабая подсказка
Аналогия: представьте, что вы даёте фото реставратору. При низком денойзинге он аккуратно подкрашивает детали. При высоком — переписывает картину заново, лишь слегка ориентируясь на оригинал.
Как влияет на картинку: при работе с фото лица, где важно сохранить черты, лучше держать денойзинг умеренным (0.4–0.6). Для радикальной смены стиля — поднять до 0.7–0.8.
💡 Совет от Мари Вельс
Не обязательно разбираться во всех терминах сразу. Достаточно понять три вещи: промт (что рисовать), сид (как воспроизвести понравившийся результат) и денойзинг (насколько сильно менять исходник в image-to-image). Эти три параметра дают вам 80% контроля над результатом. Остальное — детали, к которым приходят с опытом.
Остальные термины коротко
Токен и эмбеддинг
Токен — единица текста, которую обрабатывает нейросеть. Грубо говоря, это кусочек слова или целое слово. Когда вы вводите промт, модель сначала разбивает его на токены.
Эмбеддинг (векторное представление) — это перевод токена в набор чисел, которые модель использует для работы. Это позволяет нейросети «понять» смысл вашего запроса.
Практически: токены важны потому, что у промта есть лимит. Если промт слишком длинный, часть описания может «обрезаться». Пишите конкретно и без лишних слов.
Шаги (steps) и инференс (inference)
Шаги генерации (steps) — количество итераций, за которые модель «проявляет» изображение из шума. Больше шагов = больше времени = обычно лучше детализация. Меньше шагов = быстрее, но грубее.
Типичный диапазон: 20–50 шагов. Больше 80 обычно уже не даёт заметного прироста качества.
Инференс (inference, генерация) — сам процесс создания изображения, когда обученная модель применяет знания к вашему запросу. Это именно «вывод» модели, а не её обучение.
Апскейл (upscale)
Апскейл — увеличение разрешения изображения с помощью ИИ. В отличие от обычного масштабирования (которое просто делает пиксели крупнее), ИИ-апскейл достраивает детали: текстуры, края, мелкие элементы.
Практически: если сгенерированная картинка получилась 512×512 пикселей, а вам нужно 2048×2048 — апскейл поможет без потери качества. Попробуйте улучшить качество фото онлайн — там это делается в один клик.
Артефакты (artifacts)
Артефакты — визуальные «глюки» генерации: деформированные пальцы, лишние конечности, размытые области там, где должна быть чёткость, странные текстуры, нечитаемый текст.
Почему возникают: модель «галлюцинирует» детали, с которыми ей статистически сложно — например, руки с 6 пальцами или зубы странной формы.
Как бороться: добавить нежелательные элементы в негативный промт, увеличить число шагов, попробовать другой сид.
Чекпоинт (checkpoint)
Чекпоинт (checkpoint) — это конкретная «версия» обученной модели, сохранённая в файл. Stable Diffusion v1.5, SDXL, FLUX.1-dev — всё это чекпоинты.
Разные чекпоинты дают разный стиль по умолчанию, разную детализацию и тп. Выбор чекпоинта — это как выбор «базового художника» перед работой. Один лучше справиться с людьми, другой с природой, а третий хорош в изображении животных.
Термины про лицо
Отдельная группа терминов связана с генерацией и сохранением лиц — это одна из самых практически важных областей.
Face embedding (векторное представление лица)
Face embedding — это числовой «отпечаток» конкретного лица: набор чисел, кодирующих пропорции, форму черт, расположение элементов. Именно этот вектор передаётся в модель, чтобы она «знала», чьё лицо нужно сохранить.
Identity preservation (сохранение идентичности)
Identity preservation (сохранение идентичности) — способность модели удерживать уникальные черты конкретного человека при генерации: менять фон, наряд, освещение, но оставлять лицо узнаваемым.
Character consistency (консистентность персонажа)
Character consistency — одно лицо, узнаваемое на серии разных изображений. Критически важно для сторителлинга, рекламных кампаний, комиксов, серий иллюстраций.
IP-Adapter и ControlNet
IP-Adapter — инструмент, который «передаёт» face embedding в модель как дополнительное условие генерации. Позволяет сохранять лицо без полного переобучения модели.
ControlNet — компонент, управляющий структурой и позой в изображении: не даёт лицу «поехать» при смене ракурса.
А применить эти технологии к своим фото можно через нейрофотосессию на AVALAVA.
Мини-шпаргалка
Термин | Простыми словами | На что влияет |
Промт (prompt) | Текстовое описание того, что нужно нарисовать | На всё — это ваша инструкция |
Негативный промт | Список того, что рисовать не нужно | Убирает нежелательные элементы |
Сид (seed) | Число «стартовой точки» генерации | На повторяемость результата |
Диффузия | Как ИИ «проявляет» картинку из шума | На сам способ генерации |
LoRA | Довесок, обучающий модель на конкретное лицо или стиль | На сходство и стиль |
CFG scale | Насколько строго слушаться текста | На точность следования промту |
Денойзинг | Насколько сильно менять исходное фото | На близость к оригиналу |
Шаги (steps) | Количество итераций генерации | На детализацию и время |
Апскейл | ИИ-увеличение разрешения | На качество финального файла |
Токен | Единица текста для модели | На длину и точность промта |
Артефакты | Визуальные «глюки» | Их надо убирать через негативный промт |
Чекпоинт | Конкретная версия обученной модели | На базовый стиль и возможности |
Хотите посмотреть, как эти термины работают на практике — в конкретной задаче про текст на изображениях? Читайте «Почему ИИ научился писать текст на картинках» — там объясняются энкодеры, DiT и консистентность персонажа в контексте реального инструмента.
Посмотреть, как работает современная модель со всеми этими компонентами, можно на странице Nano Banana.
Попробуйте сами
Теперь вы знаете, что означают основные термины. Лучший способ закрепить — попробовать: введите промт, зафиксируйте сид, поменяйте одну переменную и посмотрите, что изменилось.